13/03/2026
Apache com SSL: servidor web seguroConfigurar Apache no Ubuntu e ativar HTTPS com certificado SSL para hospedar sites e apps.
Artigos
Artigos · 13/06/2025
Do Mario 64 aos jogos atuais: o que a GPU calcula e por que o paralelismo muda o desempenho gráfico.
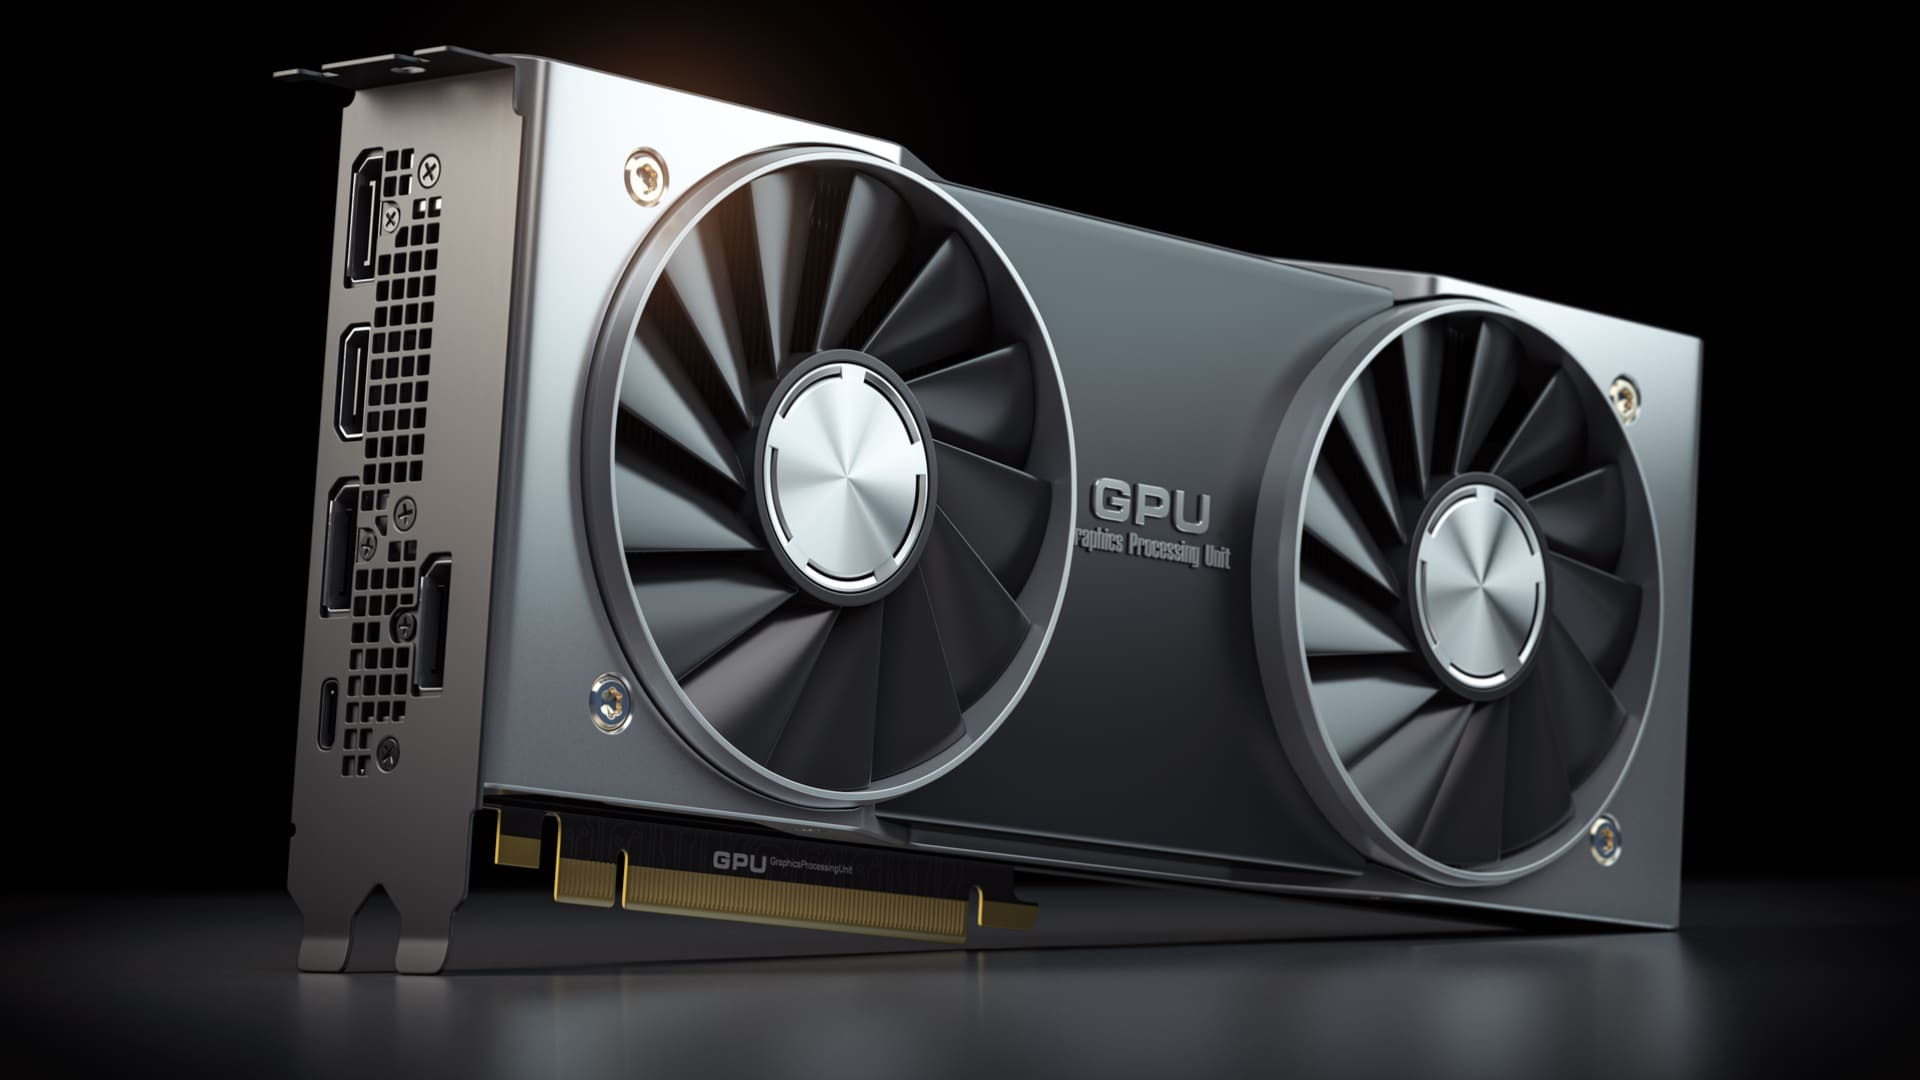
Quantos cálculos você acha que a sua placa de vídeo realiza a cada segundo quando executa jogos com gráficos incrivelmente realistas? 100 milhões de cálculos por segundo é o que é necessário para rodar o Mario 64 que é lá de 1996
Então quem sabe 100 bilhões de cálculos por segundo bem com isso você teria um computador lá de 2011 aquele da Positivo para rodar o Minecraft.
Então se você quiser rodar jogos super realistas como Cyberpunk 2077 você precisa de uma placa de vídeo que consiga realizar cerca de 36 trilhões de cálculos por segundo. Estamos falando de um número tão absurdo que chega a desafiar a imaginação de qualquer um
Vamos imaginar o seguinte: você faz uma conta de multiplicação bem complicada, daquelas com vários números grandes, uma vez por segundo. Agora, pense que cada uma das 8 bilhões de pessoas no planeta Terra esteja fazendo essa mesma conta, cada uma com números diferentes, uma vez por segundo.
Mesmo assim, para alcançar o poder de processamento de uma única placa de vídeo, seria necessário ter 4.400 Terras inteiras, cada uma cheia dessas 8 bilhões de pessoas, fazendo essa operação ininterruptamente 24 horas por dia, a cada segundo.
Ou seja, a GPU consegue realizar em um instante o que exigiria uma quantidade absurda de pessoas trabalhando juntas sem parar.
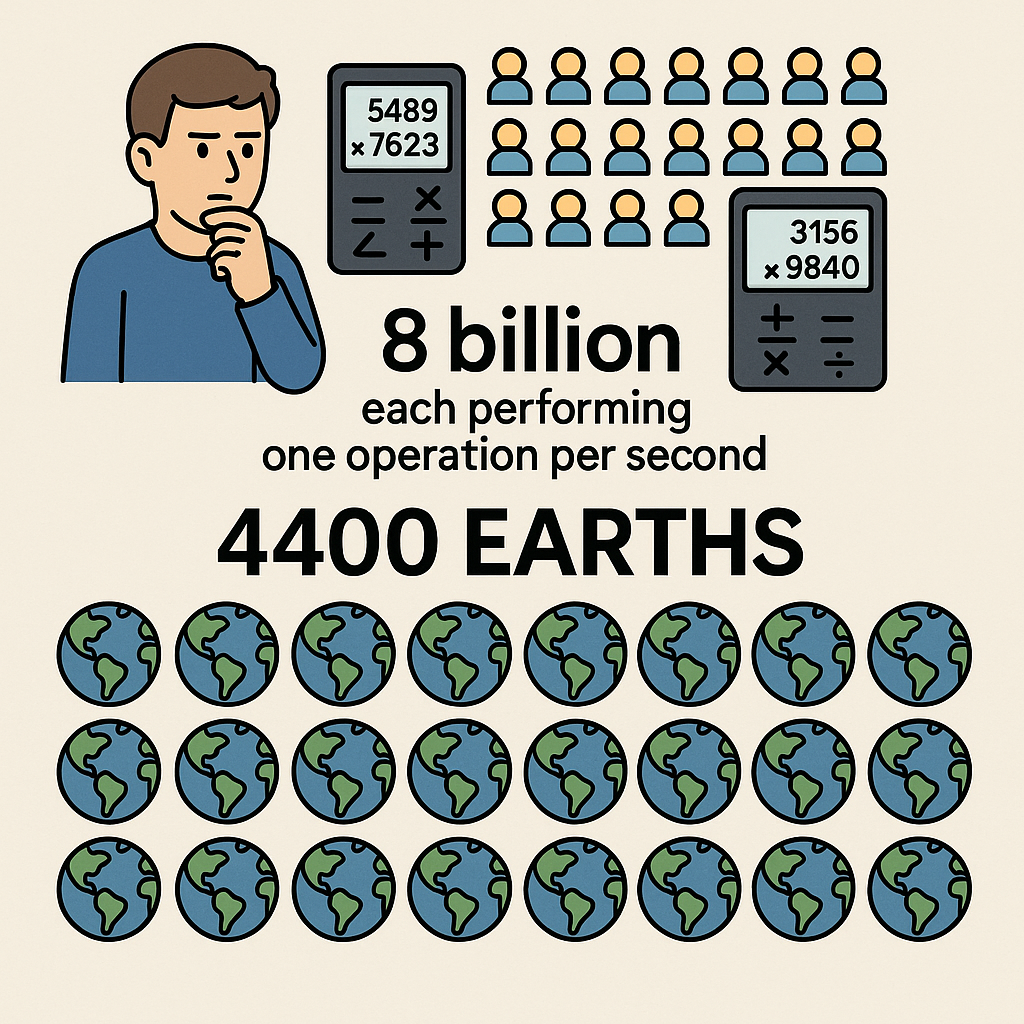
Isso só mostra o quão impressionante é a tecnologia de uma placa de vídeo e que cabe dentro do seu PC mas que executa cálculos em uma escala que ultrapassa a capacidade coletiva de civilizações inteiras
Vamos abrir uma placa de vídeo e examinar cada componente interno desde o design físico até os chips e arquitetura que fazem tudo funcionar E porque ela é uma ferramenta perfeita para tarefas como renderização gráficas em jogos mineração de criptomoedas redes neurais e inteligência artificial
Antes irmos para dentro de uma placa de vídeo é essencial entender qual a diferença entre GPU e uma CPU
Dentro de uma placa de vídeo existe um chip chamado GPU — sigla para _Graphics Processing Unit_, ou Unidade de Processamento Gráfico. Ele é responsável por realizar milhares de cálculos em paralelo e, em muitos modelos modernos, pode ter mais de 10.000 núcleos de processamento.
Agora compare isso com uma CPU, o processador principal do seu computador, que normalmente tem entre 6 e 24 núcleos. À primeira vista, pode parecer óbvio que a GPU é muito mais poderosa, afinal, tem milhares de núcleos contra algumas dezenas da CPU. Mas a diferença entre elas vai além da quantidade de núcleos — e aqui entra uma analogia simples para ilustrar isso:
Imagine que a GPU é como um enorme navio cargueiro, enquanto a CPU é como um avião jumbo. O navio pode transportar uma quantidade gigantesca de carga — assim como a GPU pode processar milhares de tarefas ao mesmo tempo — mas ele é lento. Já o avião, embora carregue bem menos carga, é muito mais rápido e versátil: transporta passageiros, pacotes e contêineres, e pode pousar em praticamente qualquer lugar do mundo.
Da mesma forma, a CPU se destaca por sua flexibilidade: ela consegue lidar com diferentes tipos de tarefas, instruções e aplicativos com muita eficiência. Já a GPU, embora extremamente poderosa em cálculos paralelos, não é tão versátil. Ela é ideal para realizar milhares de operações simples ao mesmo tempo — como somas, multiplicações e divisões — mas não foi projetada para tarefas como rodar um sistema operacional, abrir programas ou se comunicar com todos os periféricos do computador.
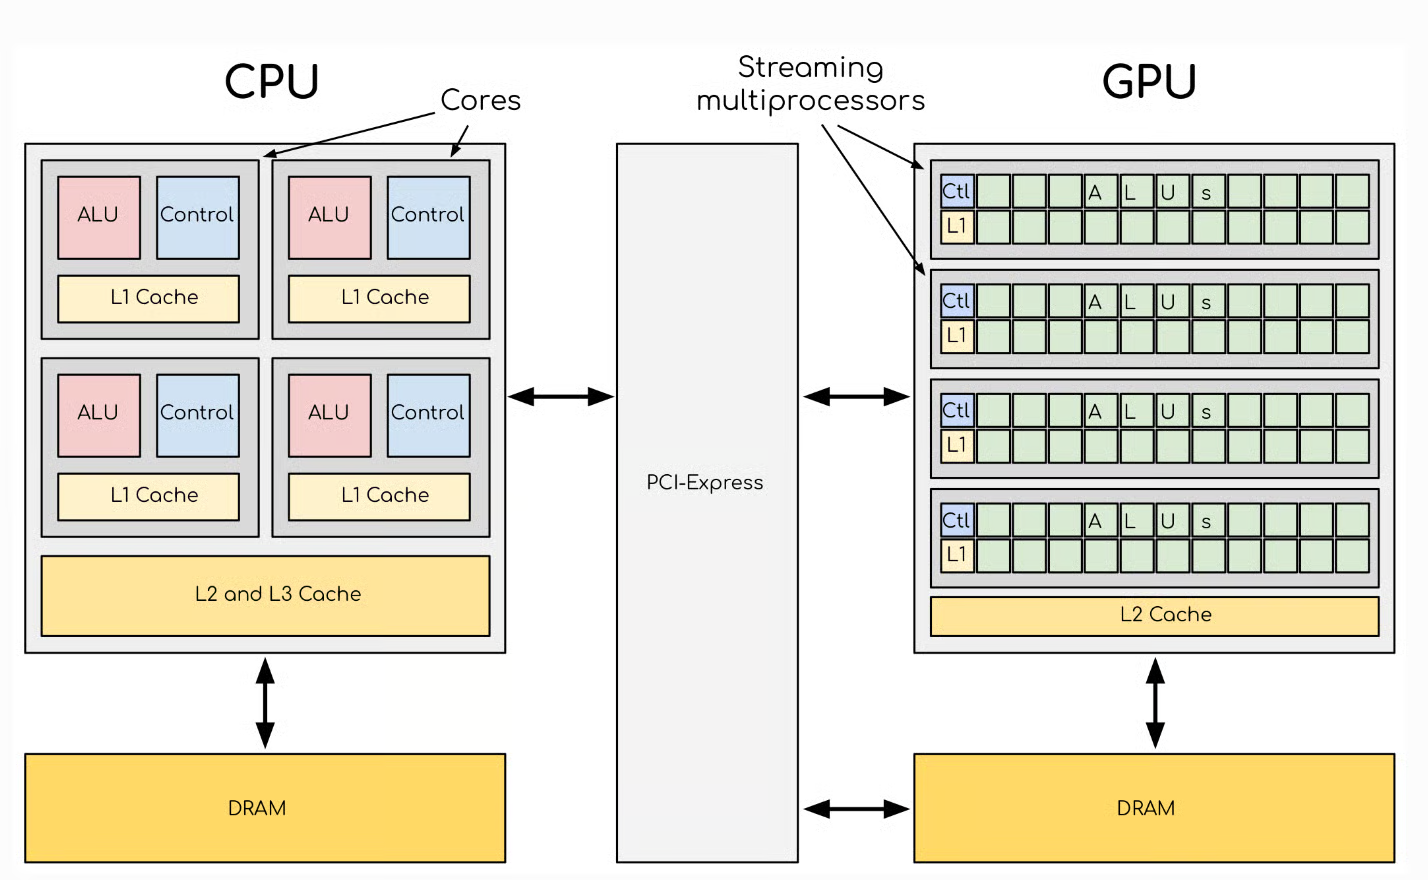
Ou seja, se você precisa processar uma enorme quantidade de dados e fazer milhares de cálculos simultaneamente, a GPU é imbatível. É por isso que ela se destaca em áreas como jogos, inteligência artificial e renderização 3D. Por outro lado, se a tarefa exige rapidez em operações complexas e variadas, ou envolve poucas informações mas com alta precisão e controle, a CPU será a escolha mais adequada.
Vamos tomar como exemplo a RTX 3090. Basicamente, uma placa de vídeo é uma placa de circuito impresso — conhecida como PCB (Printed Circuit Board) — onde estão organizados diversos componentes responsáveis pelo funcionamento da GPU.
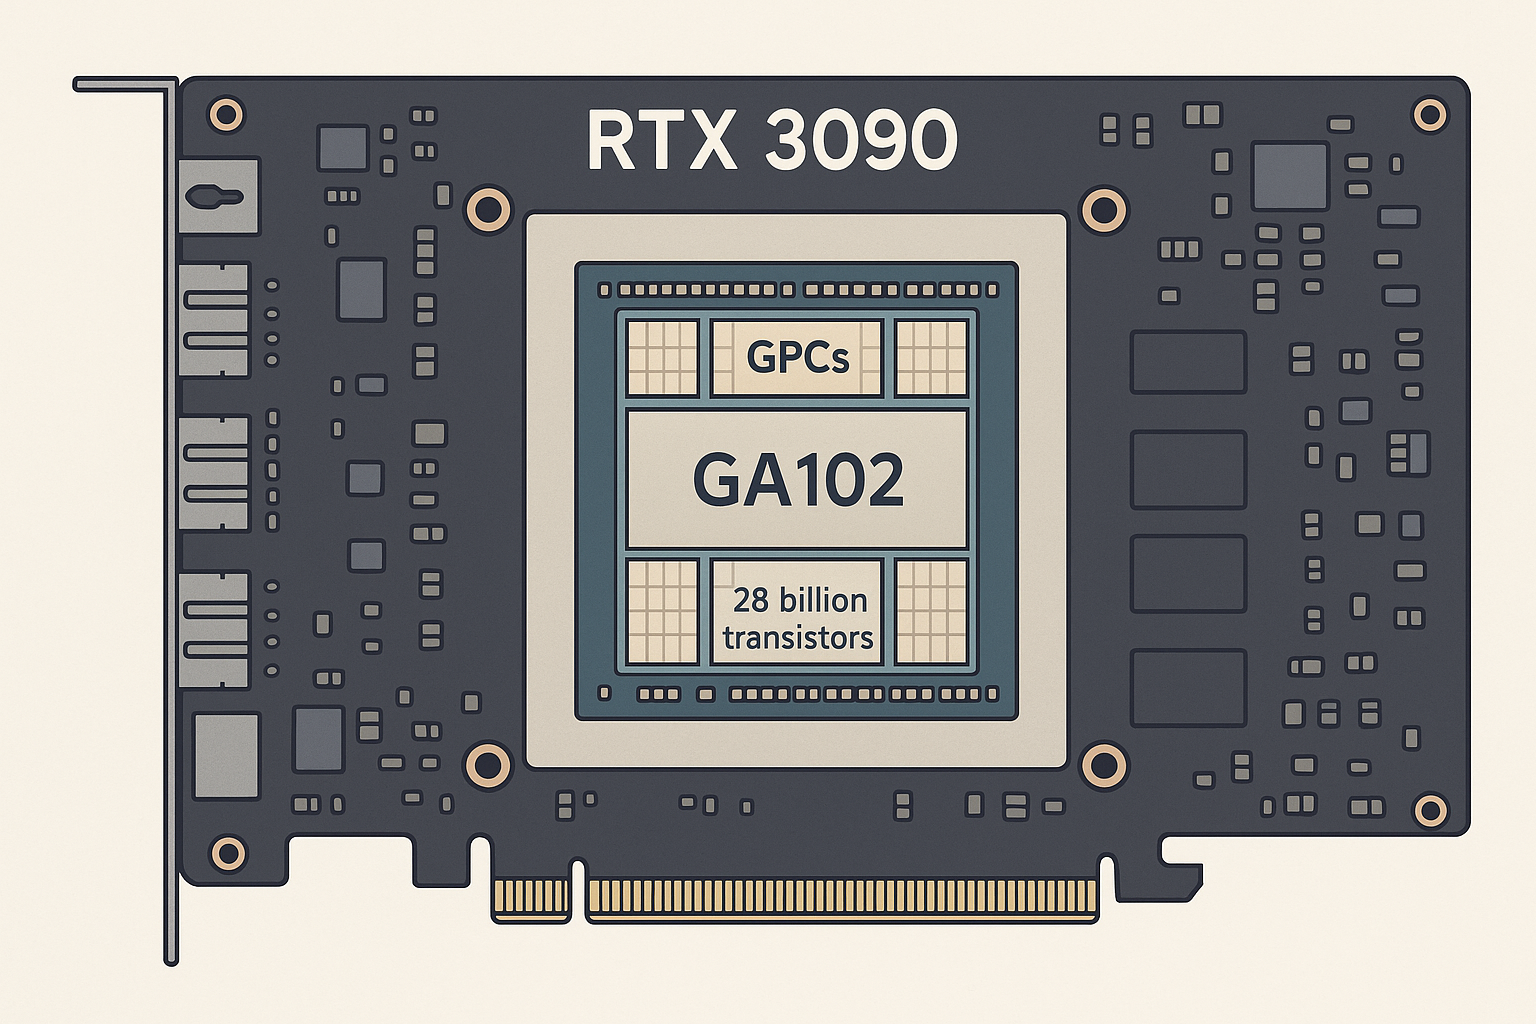
No centro dessa placa, está o verdadeiro cérebro da operação: a GPU. No caso específico da RTX 3090, esse chip é chamado GA102. Ele é uma impressionante peça de engenharia, contendo nada menos que 28 bilhões de transistores — os pequenos interruptores eletrônicos que realizam os cálculos e tornam possível todo o processamento gráfico de alto desempenho.
Tudo começa com sete unidades chamadas GPCs — _Graphics Processing Clusters_, ou Agrupamentos de Processamento Gráfico. Dá pra pensar em cada GPC como um pequeno departamento dentro da GPU, responsável por uma parte específica do trabalho gráfico, como desenhar objetos, calcular luzes, sombras e formas. Eles dividem as tarefas para que tudo aconteça de forma mais rápida e eficiente.
Quanto mais GPCs, mais tarefas gráficas podem ser executadas em paralelo, como uma equipe bem organizada dividindo funções em um projeto grande.
Dentro de cada GPC, existem 12 SMs, que são os _Streaming Multiprocessors_ — pense neles como mini fábricas de processamento. E dentro de cada uma dessas “fábricas”, temos:
No total, a RTX 3090 entrega aproximadamente:
Esses números mostram o poder massivo de processamento paralelo que essa placa oferece — e por isso ela é tão usada em jogos de última geração, IA e aplicações de renderização 3D.
Cada tipo de núcleo dentro da GPU tem uma função muito bem definida.
Placas de vídeo da mesma geração, como RTX 3080, 3080 Ti, 3090 e 3090 Ti, costumam usar o mesmo chip gráfico. A diferença entre elas está na quantidade de núcleos ativos, clock e memória.
Durante a fabricação, alguns chips saem com defeitos em partes específicas. Em vez de descartar, os engenheiros desligam só os núcleos defeituosos e usam o restante. Esse processo é chamado de binagem.
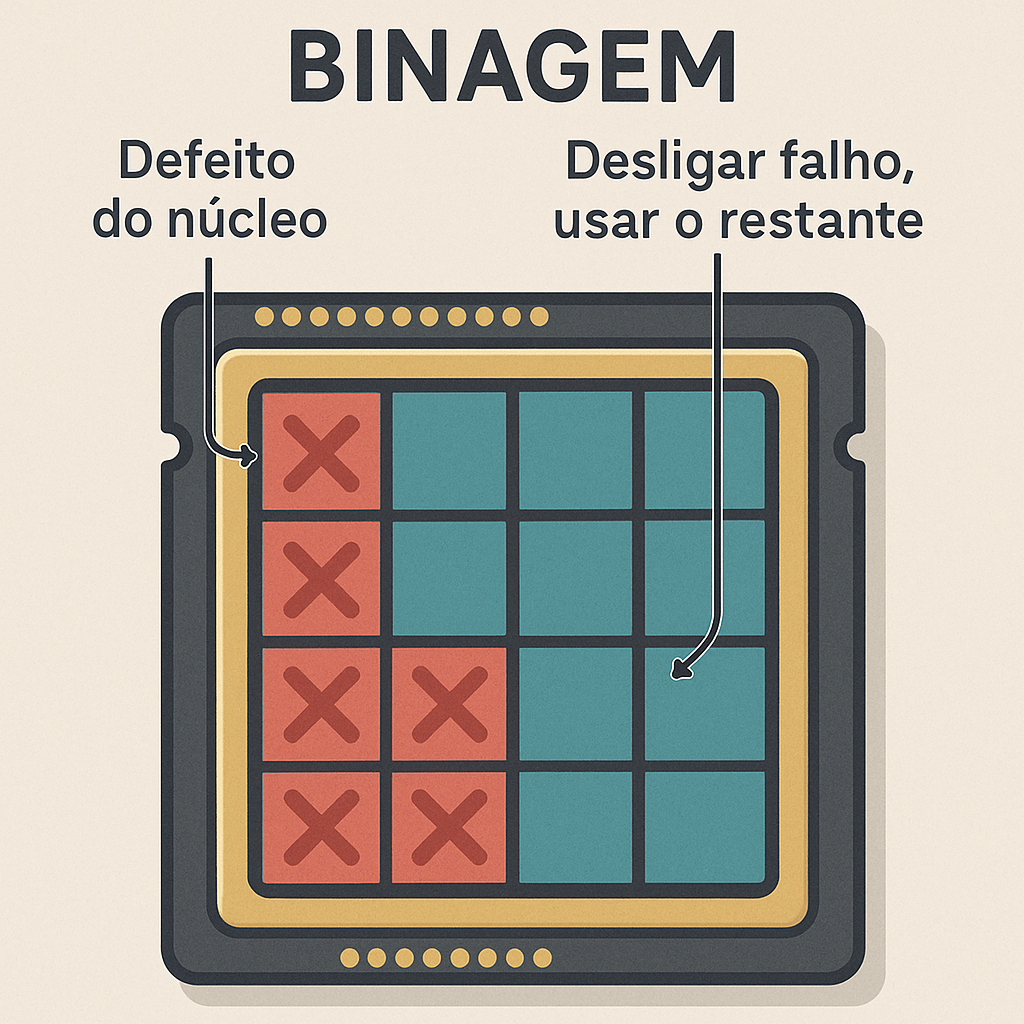
Assim, um chip com mais núcleos funcionando vira um modelo topo de linha (ex: 3090 Ti), e os com menos núcleos ativos viram modelos inferiores (ex: 3080). Isso torna o processo de fabricação mais eficiente e econômico.
Um núcleo CUDA (Compute Unified Device Architecture) é como um pequeno processador dentro da GPU da NVIDIA, projetado para executar cálculos paralelos em alta velocidade.
Imagine que você quer aplicar um filtro em uma imagem 4K. Um processador tradicional (CPU) faz isso em série, pixel por pixel. Já a GPU com núcleos CUDA processa milhares de pixels ao mesmo tempo, acelerando enormemente a tarefa.
Portanto, quanto mais núcleos CUDA, maior o potencial da GPU para lidar com tarefas pesadas de forma rápida e eficiente.
Um dos blocos mais importantes dentro da GPU realiza a operação A × B + C, conhecida como FMA (Fused Multiply-Add). Essa operação é extremamente comum e acontece bilhões de vezes por segundo.
Dentro de cada núcleo CUDA, existem unidades menores responsáveis por fazer cálculos com dois tipos de números:
Para esses casos, a GPU usa uma representação especial chamada ponto flutuante, parecida com o formato "vezes 10 elevado a alguma coisa" (notação científica), que você aprende na escola.
Essa estrutura permite que as GPUs façam cálculos extremamente rápidos e precisos, mesmo com números bem complexos.
Agora que a gente já entendeu como funciona um único núcleo cuda vamos dar um passo mais à frente e enxergar um panorama completo do restante do chip dessa RTX 3090
Ao redor das bordas do chip vocês vão encontrar controladores de memórias gráficas canais que permitem comunicação super rápidas entre a GPU e a interface PC Express responsável por conectar a placa de vídeo à placa mãe do seu PC gamer Na parte inferior do chip a gente tem ali um cash de memória que é uma espécie de memória ultra rápida usada ali para armazenar dados temporários E bem na parte central tem um controlador que organiza todo o trabalho dos cluster de processamento e dos milhares de núcleos que ja falamos.
A placa de vídeo é composta por várias partes além da GPU. De um lado estão as portas de saída (HDMI, DisplayPort) e do outro, o conector de energia (12V). Os pinos PCI Express conectam a placa à placa-mãe. Na PCB há muitos componentes, principalmente do regulador de voltagem, que transforma os 12V da fonte para cerca de 1.1V, usados pelo chip. Como isso gera muito calor, a placa possui um grande dissipador de calor com tubos e aletas, auxiliado por ventiladores que expulsam o calor.
Além da GPU, os chips de memória gráfica são fundamentais. Eles armazenam dados que a GPU usa em tempo real, como texturas, modelos e animações. Variam entre GDDR3, GDDR5, GDDR6, GDDR6X e GDDR7. Quanto maior e mais rápida essa memória, melhor o desempenho e menor o risco de travamentos nos jogos.
O chip gráfico possui uma pequena memória interna (Cache L2), útil para dados frequentes, mas insuficiente para jogos completos. Por isso, depende dos chips de memória gráfica, que fornecem grandes quantidades de dados rapidamente. A largura de barramento define quantos dados podem ser enviados de uma vez, enquanto a largura de banda mede a velocidade total dessa transferência — podendo ultrapassar 1 TB/s nas placas mais avançadas, muito acima dos 64 GB/s da memória comum do processador.
Uma curiosidade sobre as memórias gráficas modernas é que elas vão além do sistema binário tradicional de apenas 0 e 1. Para transmitir ainda mais dados por segundo, essas memórias utilizam esquemas mais avançados de sinalização. Enquanto a maioria das tecnologias trabalha com dois níveis de voltagem (um para o 0 e outro para o 1), memórias como a GDDR6X — presentes em placas das linhas RTX 3000, 4000 e nas RX 6000 e RX 7000 — adotam um sistema chamado PAM4. Esse método utiliza quatro níveis de voltagem, permitindo representar dois bits por ciclo em vez de apenas um, o que resulta em uma taxa de transferência significativamente maior.
PAM4 é a sigla para Pulse Amplitude Modulation 4-level, ou em português, Modulação por Amplitude de Pulso com 4 níveis.
A nova geração GDDR7 vai além e utiliza um sistema chamado PAM3, que trabalha com três níveis de voltagem: -1, 0 e 1. Esse esquema permite representar combinações binárias de forma mais eficiente. Em vez de enviar três bits como sinais separados, a memória agrupa esses bits e os transforma em apenas dois símbolos usando o PAM3.
Essa técnica reduz a quantidade total de sinais enviados, o que resulta em economia de energia e maior estabilidade na comunicação.
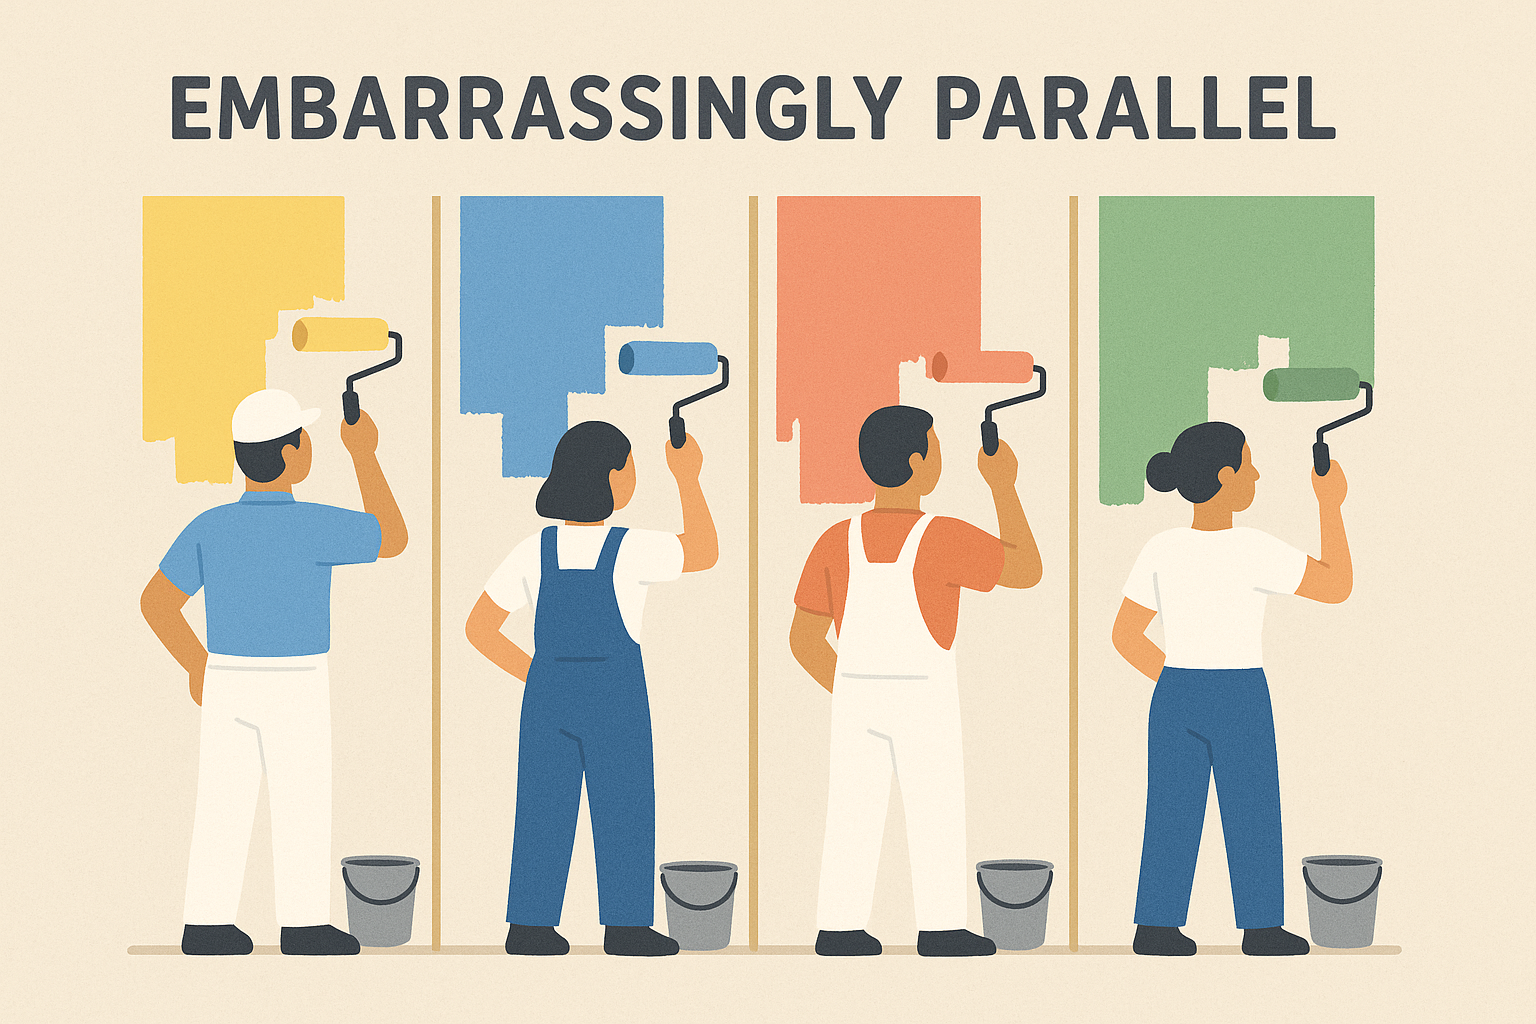
Quando uma placa de vídeo processa tarefas como jogos ou mineração de Bitcoin, ela aproveita o chamado paralelismo embaraçoso — problemas que podem ser divididos em várias partes independentes e resolvidas simultaneamente, sem depender uma da outra. Isso permite que a GPU execute muitas operações ao mesmo tempo, aumentando muito a eficiência. Imagine que você tem que pintar várias paredes. Se cada parede puder ser pintada por uma pessoa diferente ao mesmo tempo, o trabalho fica muito mais rápido. O paralelismo embaraçoso funciona assim: o problema é facilmente dividível em pedaços que podem ser trabalhados em paralelo, sem precisar esperar um terminar para o outro começar. Isso é ideal para GPUs, que possuem milhares de pequenos processadores trabalhando juntos para acelerar cálculos pesados.
A GPU consegue executar o mesmo tipo de cálculo várias vezes ao mesmo tempo usando uma técnica chamada SIMD (Single Instruction, Multiple Data), que significa "Instrução Única, Múltiplos Dados". Isso quer dizer que a placa envia um único comando para vários dados diferentes, que são processados simultaneamente.
Vamos entender como isso funciona dentro de um jogo 3D, como Red Dead Redemption 2. Imagine o chapéu do personagem Arthur, que está em cima de uma mesa. Esse chapéu não é uma peça única, mas sim formado por cerca de 28.000 pequenos triângulos, que são construídos ligando 14.000 pontinhos, chamados de vértices. Cada vértice tem uma posição medida a partir do centro do chapéu.
Agora, pense que em um jogo existem muitos objetos — cadeiras, mesas, paredes, personagens — e cada um tem seu próprio espaço e suas próprias posições locais. Para que tudo faça sentido na cena, a câmera precisa enxergar todos esses objetos juntos, no mesmo espaço de referência, que chamamos de espaço do mundo.
Mas como a placa de vídeo faz isso? Simples: para cada vértice de um objeto, ela soma a posição local desse ponto à posição do objeto no mundo. Assim, cada ponto é “colocado” no lugar certo da cena.
Parece simples, e de fato é — mas essa operação precisa ser feita milhares de vezes por segundo para todos os objetos na cena. A GPU executa essa tarefa usando uma única instrução aplicada a todos os pontos simultaneamente. Ela repete a mesma conta para o chapéu, para a mesa, para as paredes, só mudando os dados de cada objeto.
Esse é um exemplo perfeito de como a GPU usa o paralelismo para processar grandes volumes de dados de forma rápida e eficiente. E é bem aí que entra o SMD Aqui nesse exemplo temos 5.629 objetos diferentes somando 8.3 3 milhões de vértices e isso resulta em 25 milhões de contas feitas bem rápido e tudo ao mesmo tempo O segredo é que essas contas não dependem uma das outras então cada uma pode ser feita separadamente A GPU distribui essas tarefas para todos os milhares de núcleos e eles fazem tudo isso em paralelo super rápido
Agora que você já entendeu o básico do SIMD, vamos ver como isso funciona dentro do corpo de uma placa de vídeo. Cada instrução que falamos é executada por uma thread, que é como uma linha de trabalho individual. Cada thread roda em um núcleo CUDA, uma pequena parte da GPU dedicada a fazer cálculos. Essas threads são agrupadas em blocos, que por sua vez são organizados em uma estrutura maior chamada grid. Todo esse sistema é gerenciado por uma unidade chamada Streaming Multiprocessor, enquanto a distribuição das tarefas fica a cargo do Gigathread Engine, garantindo que tudo funcione de forma eficiente.
Nas placas de vídeo mais antigas, todas as threads precisavam executar exatamente a mesma tarefa, na mesma ordem e ao mesmo tempo — uma espécie de coreografia rígida. Isso é conhecido como arquitetura SIMD (Single Instruction, Multiple Data). Mas a partir de 2016, as GPUs modernas começaram a adotar a arquitetura SIMT (Single Instruction, Multiple Threads), onde cada thread pode seguir seu próprio ritmo e tomar decisões diferentes sem travar as demais. Isso é essencial para tornar os programas mais flexíveis e eficientes, já que as threads podem compartilhar memória cache e aproveitar dados umas das outras, acelerando o processamento.
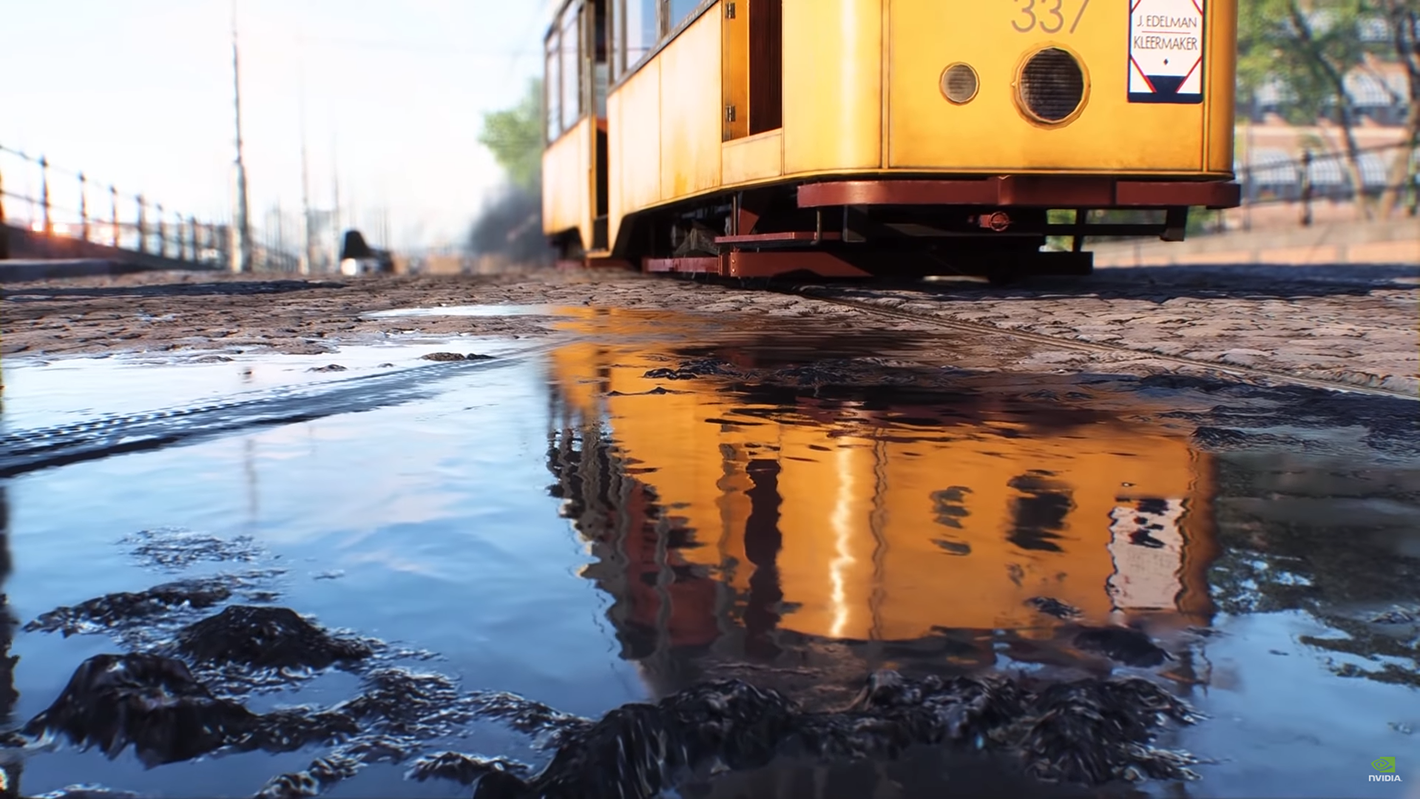
Agora, vamos falar do famoso Ray Tracing, tecnologia que vem revolucionando o realismo gráfico dos jogos. Para entender o ray tracing, precisamos lembrar como enxergamos objetos na vida real: a luz incide nos objetos, reflete, refrata e chega até nossos olhos. O que vemos é resultado de milhares de raios de luz que quicam entre superfícies, criando efeitos de reflexo, sombra e brilho.
Simular isso num computador é um grande desafio, principalmente porque muitos raios de luz não chegam à câmera, e calcular todos eles seria muito pesado. O ray tracing inverte essa lógica: ele parte da câmera e emite raios em direção às fontes de luz. Quando um raio encontra um objeto, o computador calcula como a luz interage naquele ponto, podendo ainda continuar o percurso simulando reflexos e transparências. Isso cria imagens incrivelmente realistas, imitando o comportamento natural da luz.
Porém, o ray tracing exige muito do hardware, já que os jogos precisam atualizar a tela 60 vezes por segundo ou mais. Por isso, muitos jogos usam uma combinação de ray tracing com a técnica tradicional chamada rasterização, que é o método padrão de renderização de gráficos.
Com o mercado caminhando para o ray tracing, essa técnica pode reduzir a complexidade do trabalho dos desenvolvedores, pois simula efeitos realistas de forma natural, permitindo que eles se concentrem mais na criação artística do que nos truques técnicos.
Além disso, nos últimos anos as placas de vídeo começaram a usar inteligência artificial para melhorar o desempenho em jogos, principalmente com duas tecnologias: o upscaling inteligente e a geração de quadros.
No upscaling inteligente, o jogo roda numa resolução menor, como 1080p, exigindo menos da GPU. Depois, uma rede neural treinada aumenta a imagem para resoluções maiores, como 1440p ou 4K, mantendo uma qualidade visual próxima ao nativo. Essa técnica foi popularizada pelo DLSS da Nvidia, mas já tem equivalentes como o FSR da AMD e o XCS da Intel.
Já na geração de quadros, a inteligência artificial cria quadros intermediários entre os quadros reais renderizados, aumentando a taxa de frames — por exemplo, de 60 para 90 ou 120 FPS — sem que a GPU precise processar tudo de novo. Isso melhora muito a fluidez, principalmente em jogos de ação rápida, embora possam ocorrer pequenos erros visuais em cenas muito intensas.
Essas tecnologias não só permitem que placas intermediárias rodem jogos pesados com qualidade quase 4K e ótimo desempenho, como também ajudam a reduzir o consumo de energia, evitam superaquecimento e aumentam a vida útil do hardware.
As placas de vídeo evoluem rápido, e entender como elas funcionam ajuda você não só a fazer melhores escolhas na hora da compra, mas também a valorizar a engenharia e a tecnologia por trás de cada frame que aparece na sua tela.
13/03/2026
Apache com SSL: servidor web seguroConfigurar Apache no Ubuntu e ativar HTTPS com certificado SSL para hospedar sites e apps.
20/02/2026
Quando o sinal de celular não dá conta: LoRaLoRa como alternativa de longo alcance quando não há cobertura celular — ideia simples e casos de uso.
13/12/2025
Integrando o Google Maps no Angular 18Usar @angular/google-maps, chave de API e mapa no Angular 18 a partir de um projeto real.